AI의 양대무기: KB + MC
회원 출석부나 결제 내역 같은 엑셀 데이터랑,
상담 일지나 강습 시간표/매뉴얼 같은 문서들을
한 번에 싹 엮어서 AI한테 물어볼 순 없을까?
따로따로 찾아보려니 머리가 터질 것 같아...
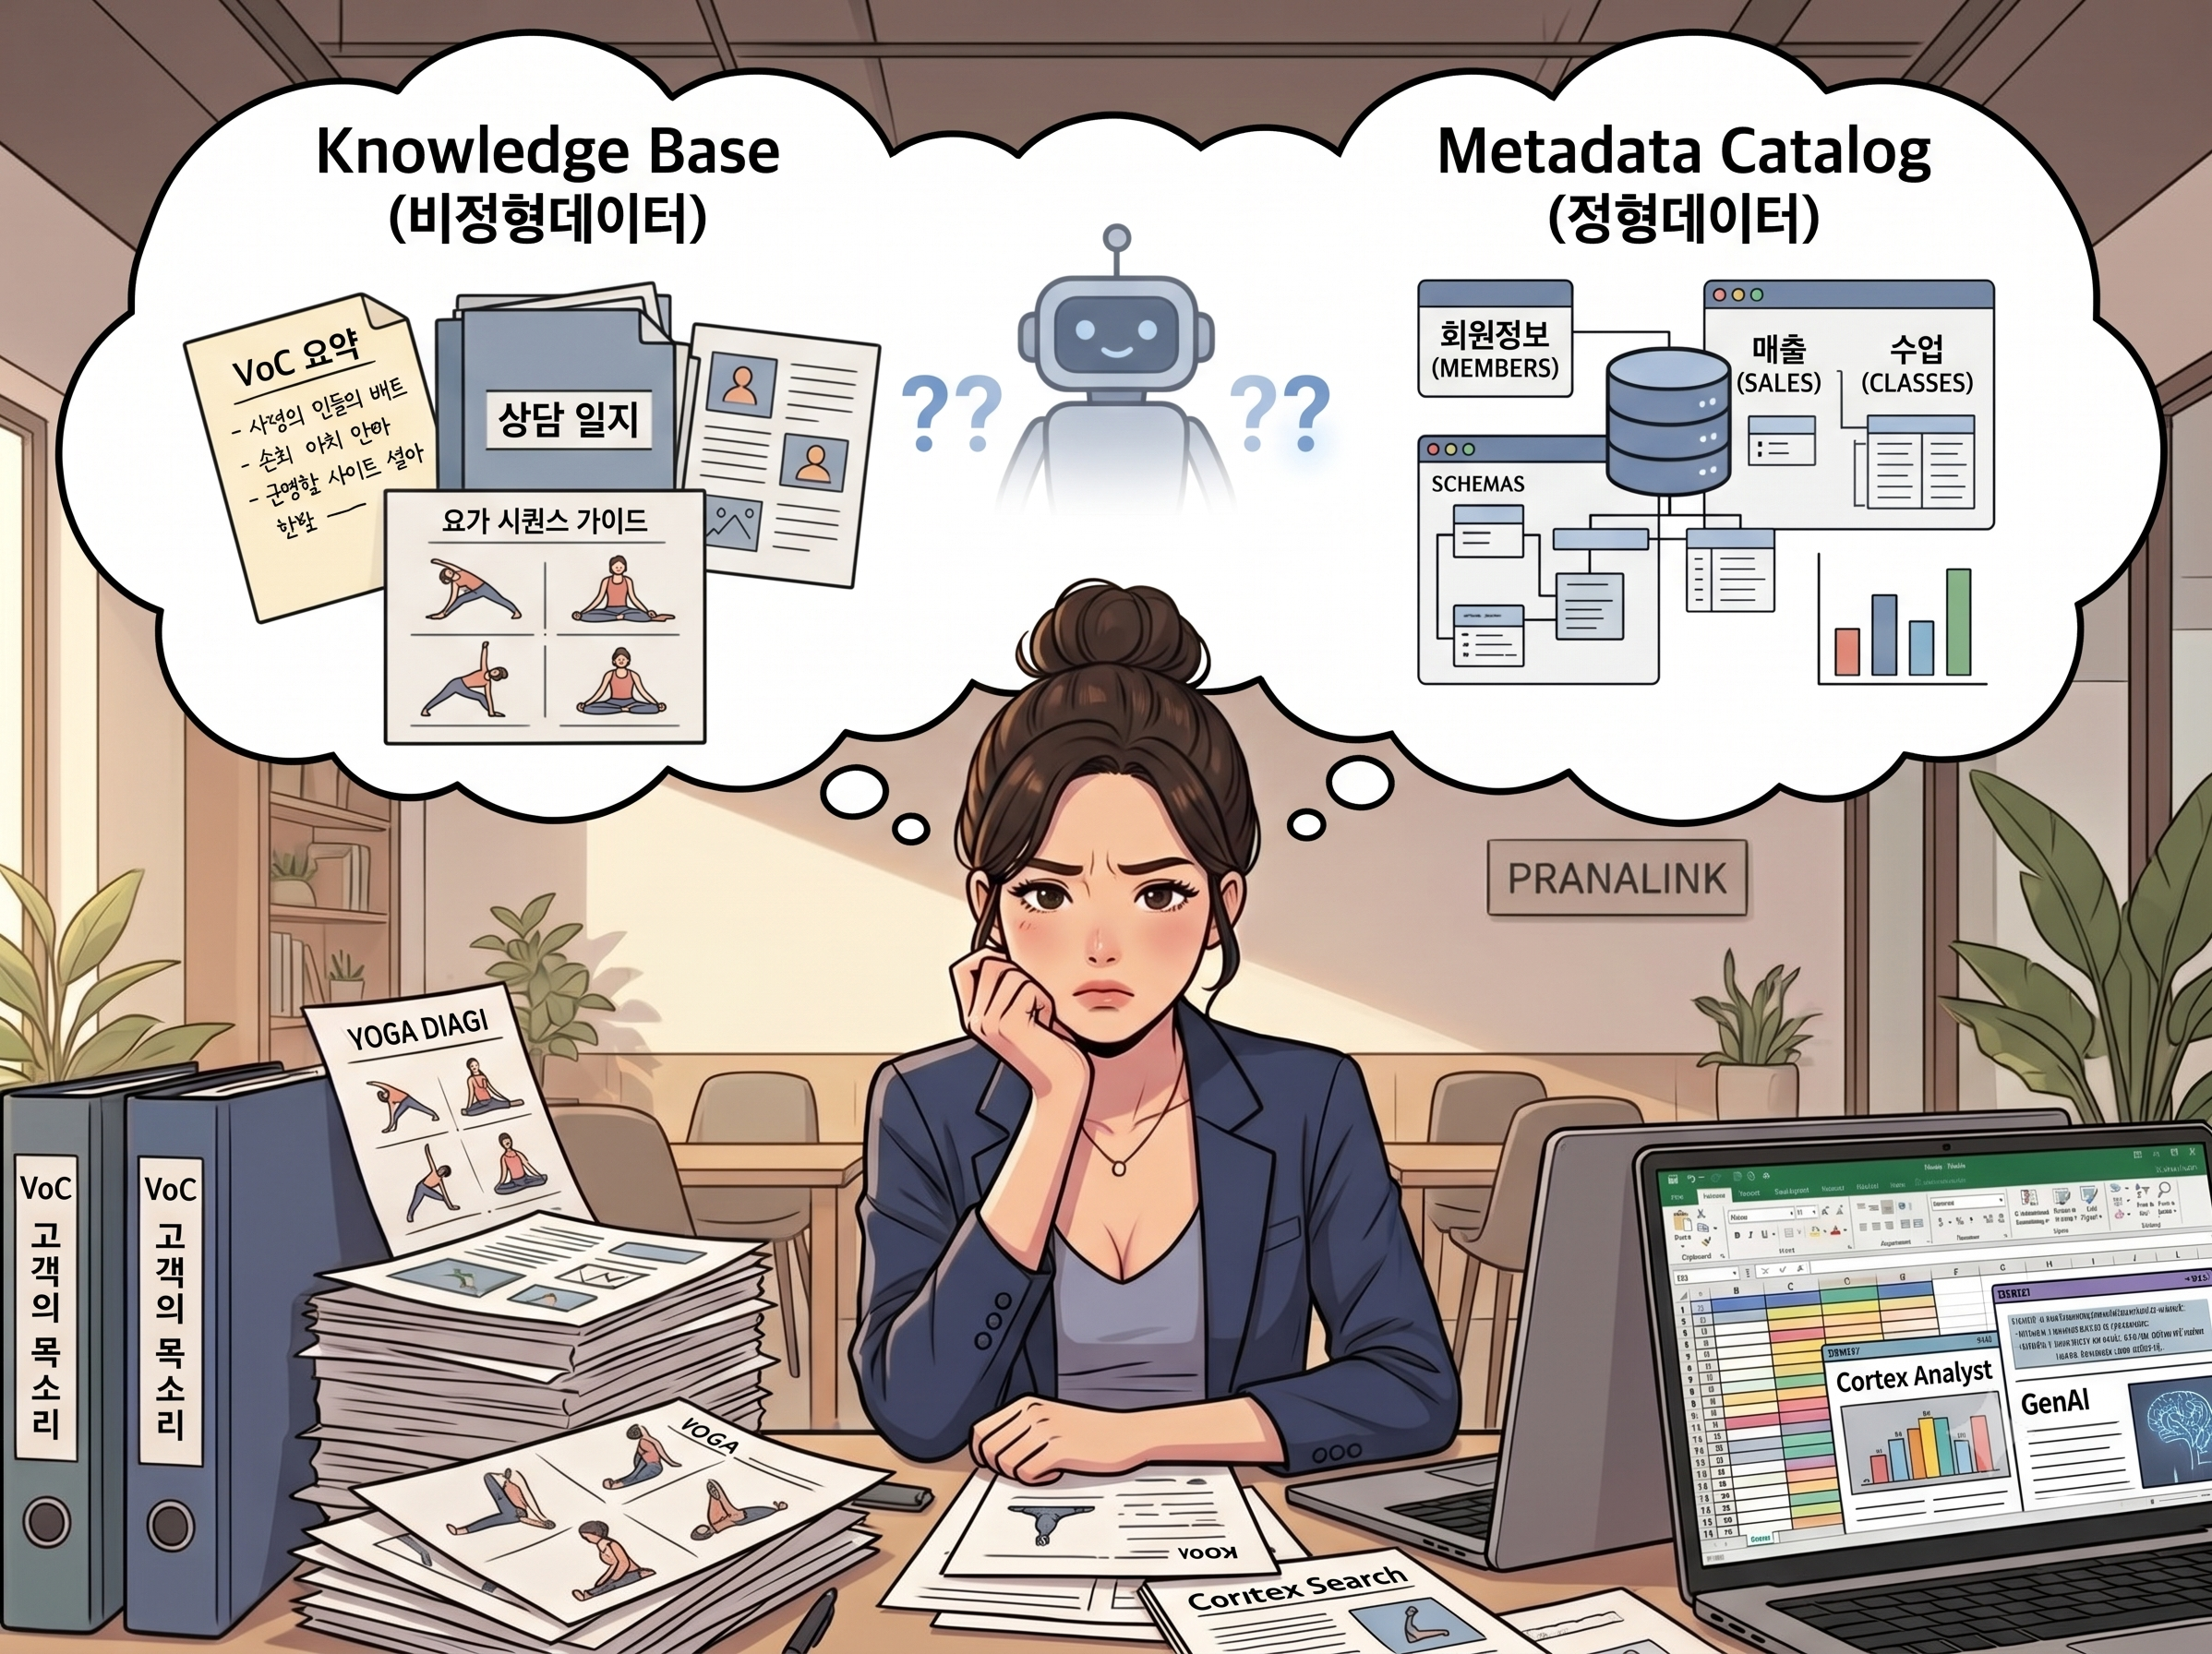
어익후, 우리 나연이가 요가 센터를 넘어 웰니스 스타트업(PRANALINK)으로 나아가기 위해 많은 생각을 하고 있는 걸 보니 대견하네.
그러면 최근에 느끼고 있는 삼촌의 이야기를 살짝 해볼까?
삼촌은 요즘 현장에서 만들고 있는 도구들을 크게 두가지 타입으로 구분하려 해.
첫째는 AI 타입.
우리가 흔히 아는 챗봇형 에이전트야. 대화를 통해서 질문에 답해주며 업무를 돕는 AI 비서지
나연이에겐 지금 '나비'가 그런 역할을 해주고 있고.
둘째는 BI 타입.
BI는 비즈니스 인텔리전스(Business Intelligence)라고 해서 사실 꽤 오래된 개념이란다.
비즈니스에 도움이 되는 인사이트(Insight)를 얻기 위해, 복잡한 데이터를 한눈에 보기 쉬운 대시보드(현황판) 형태로 시각화 하는 거야.
예를 들면 이번 달 나연이네 센터에서 가장 인기 있는 수업이나 회원들의 주된 불편 사항을 보기 쉬운 차트로 표현하는 거지. 엑셀 숫자 속에 파묻혀 있을 때는 미처 보이지 않던 흐름이 차트로 보면 단번에 드러나거든.
삼촌이 요즘 현장에서 시스템을 설계하다 보면, 데이터와 AI 프로젝트는 결국 이 두 가지 축으로 굴러가게 되더라고.
그런데 이런 결과물들을 만들면서 뼈저리게 느끼는 점이 하나 있어.
전통적인 '워터폴(Waterfall)' 방식처럼 처음부터 끝까지 기획서대로만 만드는 개발은 AI 에이전트와는 잘 맞지 않는 옷 같아. 오히려 일단 빠르게 프로토타입을 만들고, 다양한 프롬프트를 넣어보며 답변을 다듬고 가드레일을 덧붙여가는 '애자일(Agile)' 방식이 훨씬 적절하단다.
반면 BI 대시보드를 구성하는 다양한 위젯(비즈니스 로직 + 데이터 + 차트 디자인)들은 요즘 코드 어시스턴트 덕분에 정말 눈 깜짝할 사이에 뚝딱 만들 수 있어. 오히려 진짜 고민은 '이 시스템을 유지하기 위한 클라우드 비용을 어떻게 최적화할 것인가'에 있지.
그리고 이 모든 과정을 관통하는 가장 핵심적인 본질은 결국 '데이터'야.
현업에선 정작 필요한 데이터는 하나도 수집·정제해두지 않은 채, "요즘 다들 AI 쓴다는데 우리 회사는 뭐 하냐, IT팀은 왜 조용하냐"며 답답한 소리만 앞세우는 경우가 정말 많단다. 그럴 때 삼촌이 늘 해주고 싶은 말은 딱 하나야.
중요한 건 유행하는 껍데기 기술이 아니라, 조직에 잘 준비된 '데이터'입니다.
만약 나연이 주변에서도 "우리도 AI 도입하자!"고 외치는 사람이 있다면, 가장 먼저 "그럼 우리 센터의 데이터부터 제대로 모으고 다듬는 작업부터 시작해요"라고 이야기해 줘야 해.
그래서 삼촌이 현업과 치열하게 머리를 맞대고 나면, 결국 우리 팀이 해야 할 일은 아래 4가지로 압축되곤 해.
- 새로운 데이터를 입력받을 탄탄한 운영 시스템(OLTP) 구축
- AI와 분석계가 필요로 하는 데이터를 채워 넣을 파이프라인 구현
- 모인 데이터의 품질을 높이는 정제 작업 (이건 현업의 도움이 절실하지!)
- 정제된 데이터의 실전 활용: 비용 최적화된 BI 대시보드 + 똑똑한 대화형 AI 에이전트
특히 대화형 AI를 구현할 때는 크게 3가지 방식으로 접근하고 있어.
- Knowledge Base(KB)를 활용한 RAG 질의형 (비정형 데이터)
조직에 쌓인 문서나 텍스트를 RAG로 만드는 거야. 예전에 나연이가 2호점을 열 때, 회원들의 VoC(고객의 소리)를 분석해서 고객의 숨은 고충을 찾아냈잖아? 그 VoC나 상담 일지 같은 걸 데이터화하는 게 바로 KB란다.
여기서 핵심은 RAG 기술 자체가 아니야. 기술은 이미 너무 쉬워졌거든. 진짜 중요한 건 'AI가 맥락을 잘 이해할 수 있도록 데이터를 쪼개고(Chunking) 깔끔하게 다듬는 전처리 과정'이란다.
(삼촌은 요즘 이걸 해결하려고 Snowflake의 Cortex Search를 적극적으로 활용하고 있어. 비정형 문서를 벡터화하고 검색 파이프라인으로 연결하는 수고를 엄청나게 덜어주거든!) - Metadata Catalog(MC)와 시맨틱 모델을 활용한 Text-to-SQL 질의형 (정형 데이터)
정형 데이터를 아주 잘(!) 정제해 두고, 나연이가 자연어로 편하게 물어보면 AI가 그걸 SQL 명령어로 바꿔서 DB를 조회해 주는 기술이야.
하지만 데이터 정제 품질이 엉망이면 AI는 엉뚱한 거짓말(환각)을 내놓게 돼. 틀린 매출 숫자를 알려주는 AI 비서는 아무 쓸모가 없잖아? 결국 신뢰할 수 있는 데이터가 준비되어 있어야만 쓸 수 있는 고급 무기지.
(이 정형 데이터 질의 영역을 가장 우아하게 풀어낸 도구가 바로 Snowflake의 Cortex Analyst란다. 비즈니스 용어와 스키마를 연결해서 정확한 Text-to-SQL을 뽑아내는 핵심 병기지.) - 그 외 특화 도구 활용형
필요에 따라 요가 동작이나 강습 영상을 인식해서 피드백을 주는 식의 멀티모달 도구들을 결합하는 형태야.
그래서 삼촌이 그리는 '나연 유니버스의 AI 비서, 나비'의 완성형은 이런 모습이야.
- 왼손에는 비정형 데이터를 꿰뚫는 KB (Cortex Search)
- 오른손에는 정형 데이터를 정확하게 뽑아내는 MC (Cortex Analyst)
- 그리고 이 양손의 도구를 조율하고 통제하는 지능형 오케스트레이터, Cortex Agent(온톨로지 두뇌)!
예전에는 이 시스템을 구축하려면 오픈소스 모델 띄우고, 벡터 DB 따로 파고, 복잡한 파이프라인을 기워 붙이느라 진땀을 뺐거든. 그런데 Snowflake 생태계 안에서 Cortex가 이 두 가지 무기를 완벽하게 지원해 주니까, 비로소 데이터 보안 걱정 없이 단단한 엔터프라이즈 에이전트를 올릴 수 있게 되었단다.
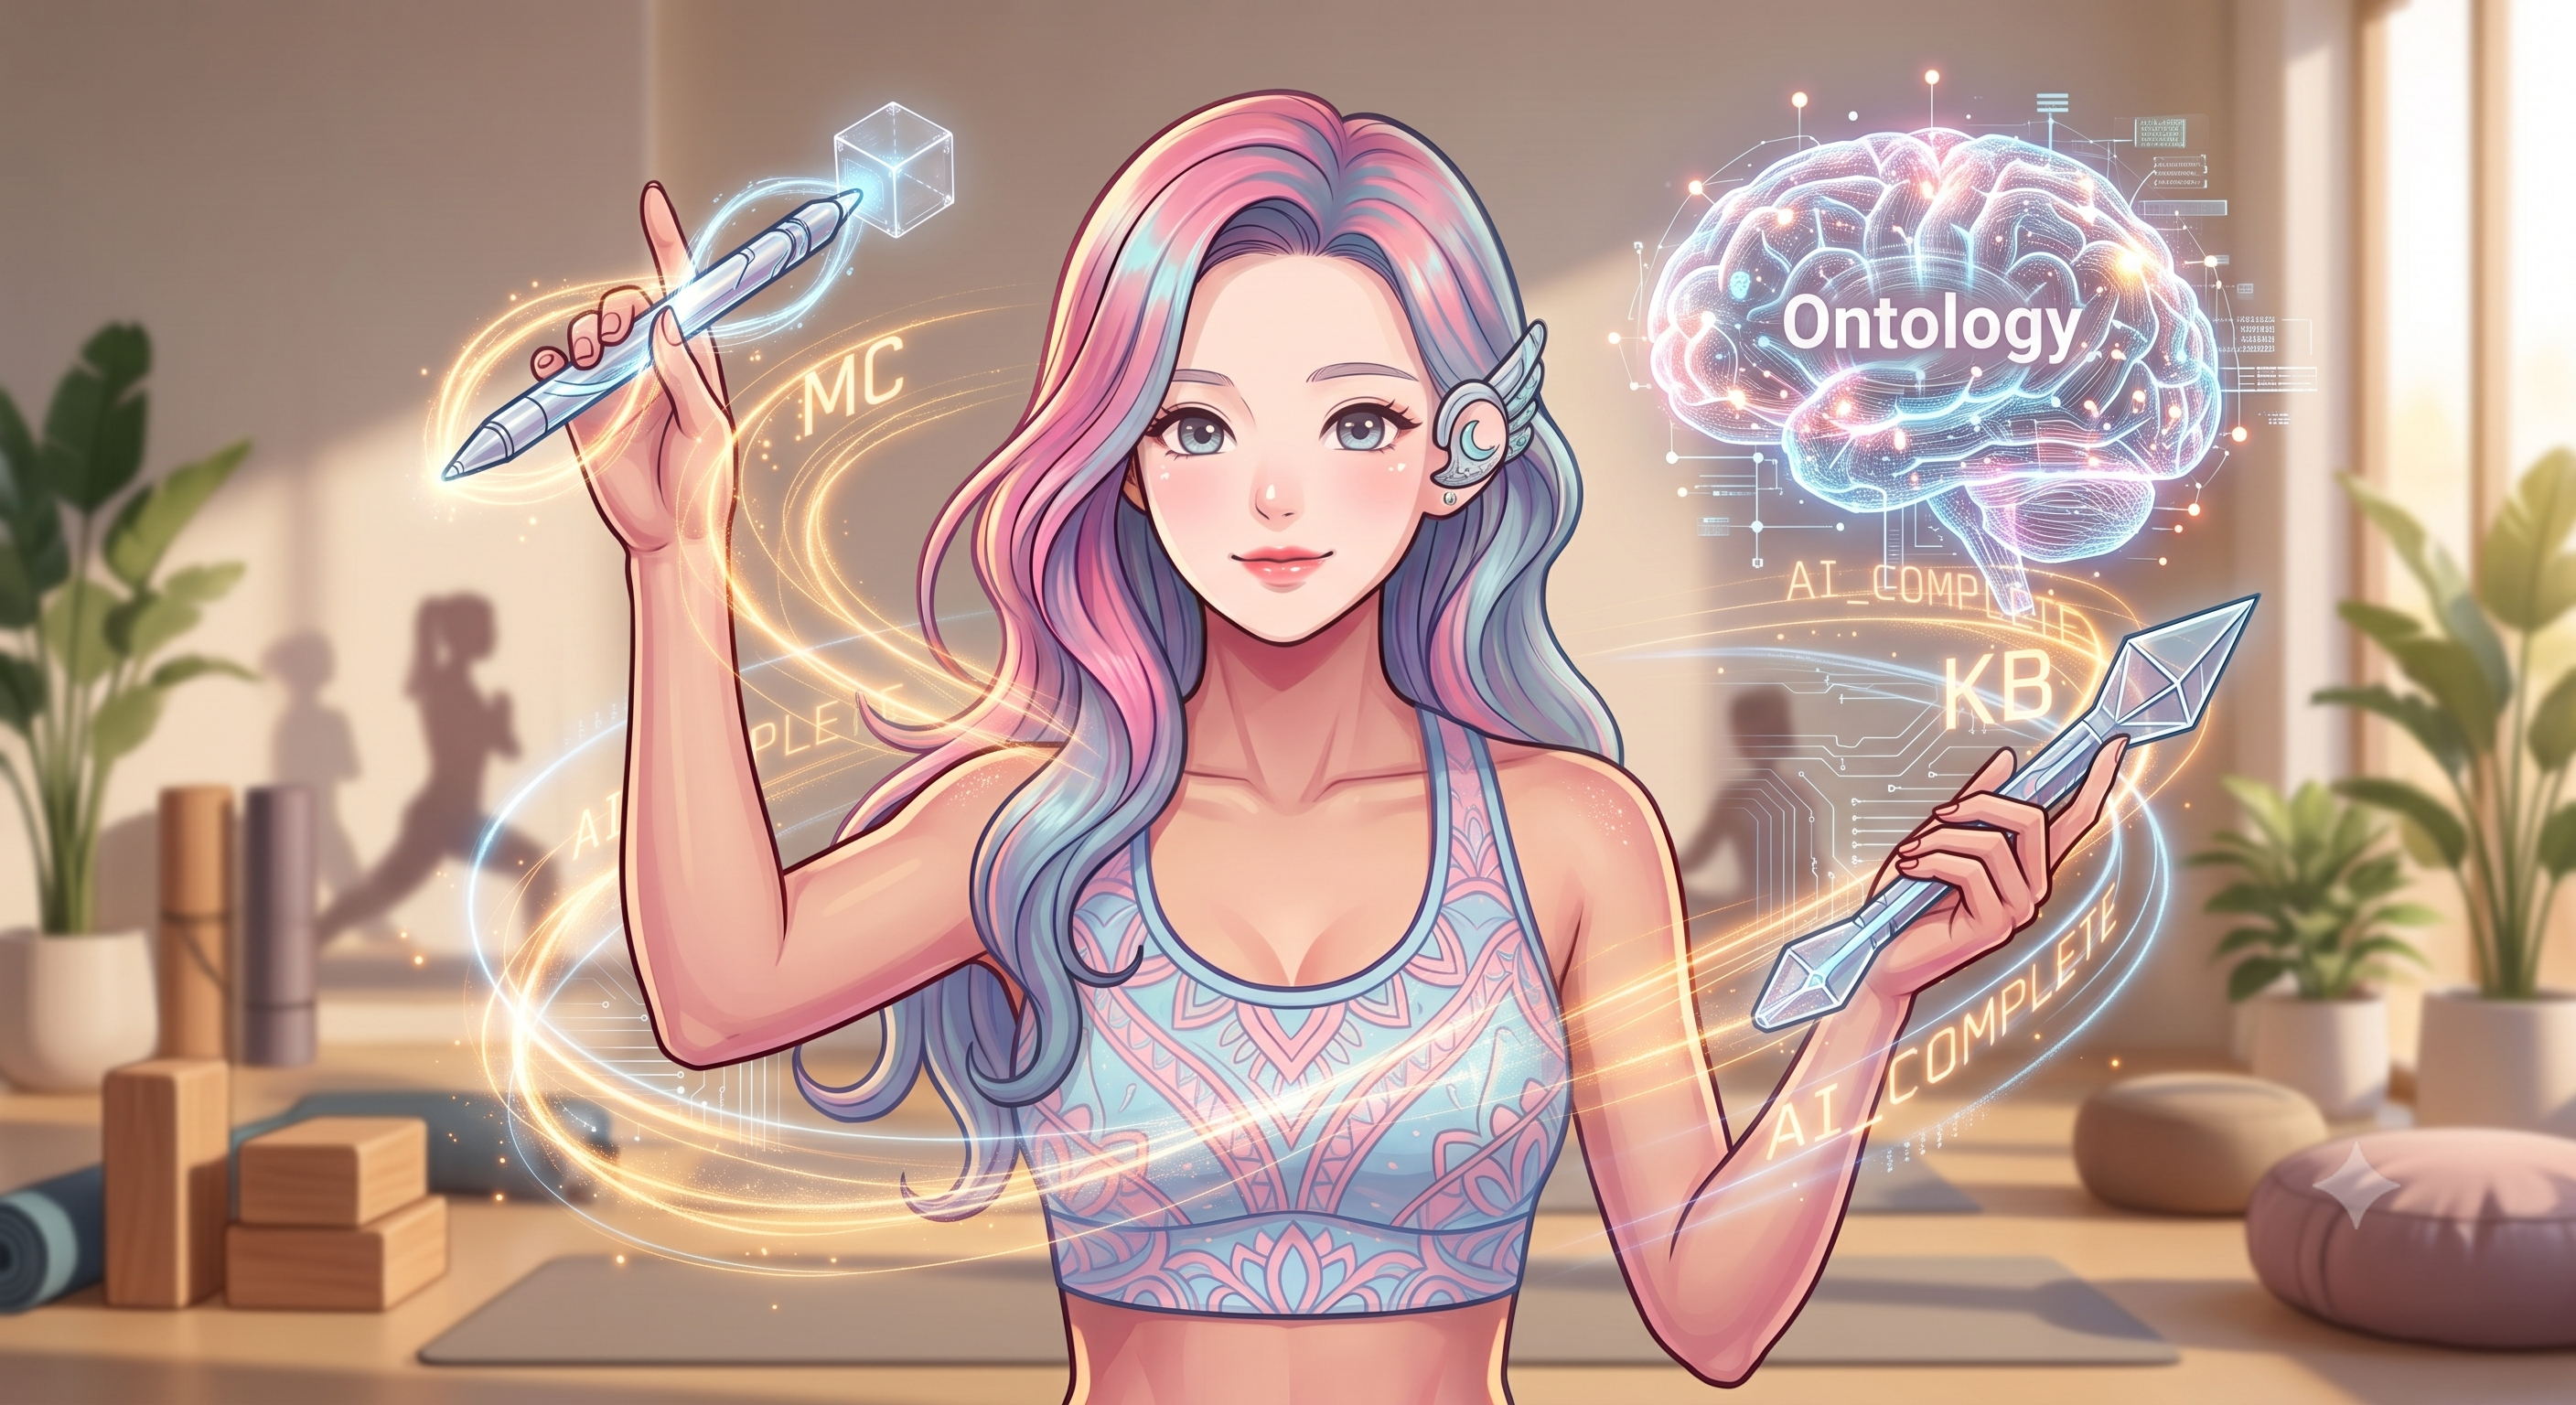
회사의 가장 중요한 우선순위와 규칙, 관계(온톨로지)를 머리에 탑재한 채 양손의 데이터를 자유자재로 다루는 지능형 에이전트.
이게 바로 삼촌이 생각하는 가장 이상적인 에이전트 아키텍처란다.
어때, 삼촌이랑 같이 '나비'에게 이 강력한 두뇌와 양손의 무기를 장착하러 가볼까?